絵コンテなしで、ここまで動く。生成AIリレーでつくるWebアニメーション
生成AIを活用し中小企業の課題解決に伴走するパートナー
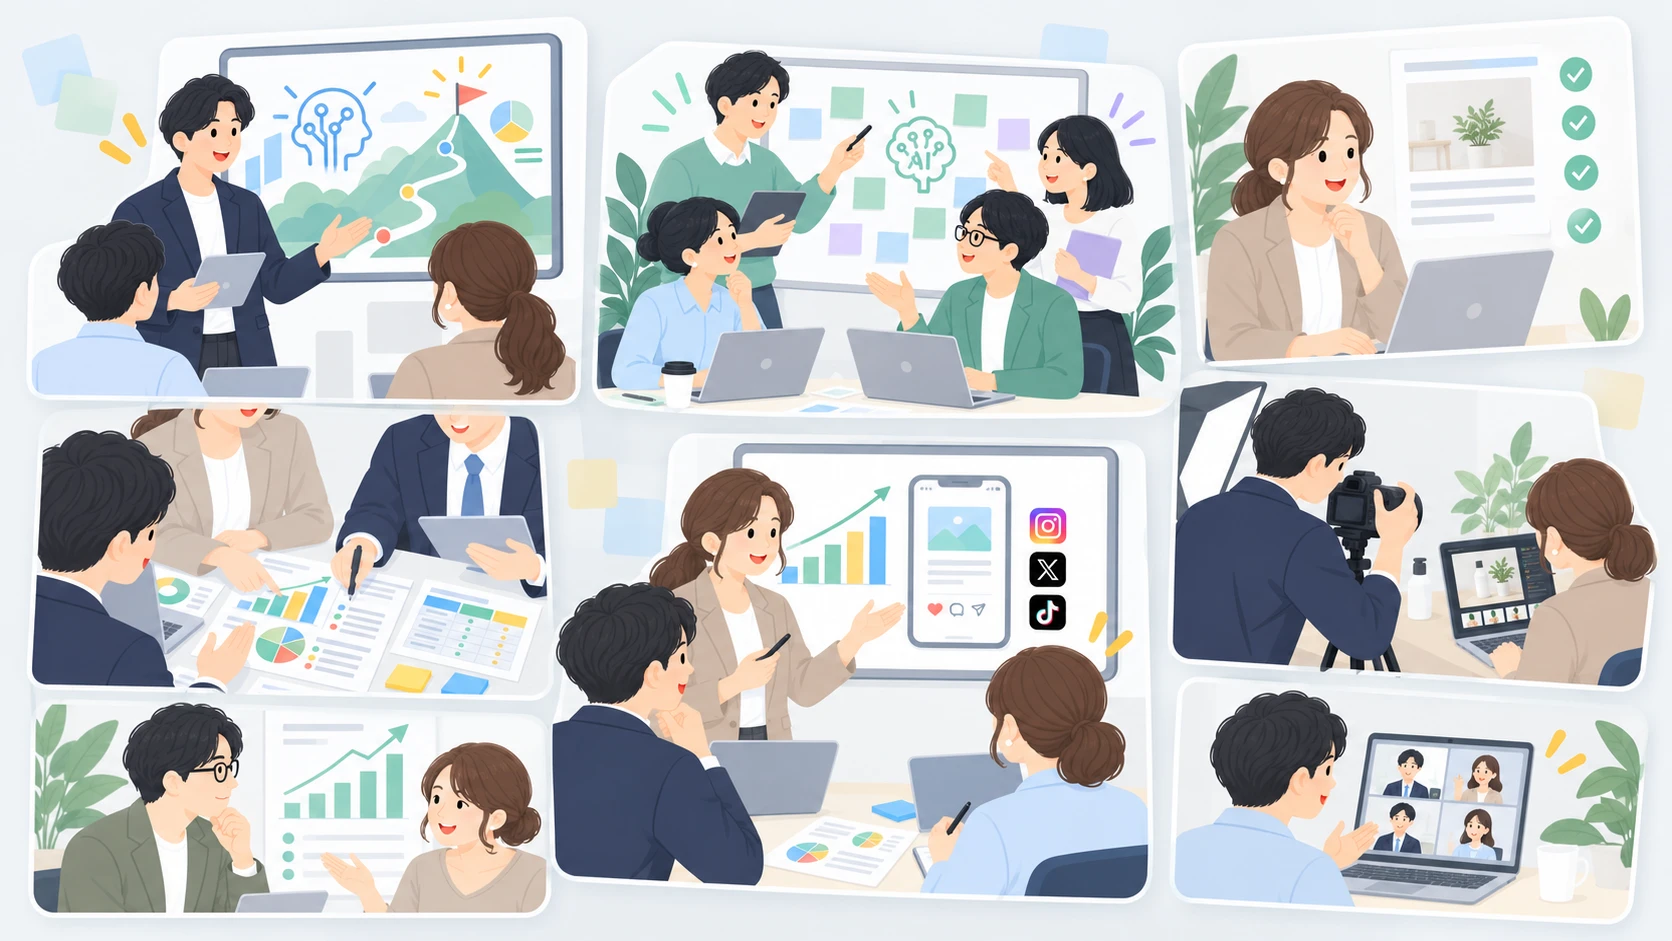
Twelfthの「AIビジネス活用・内製化支援プログラム」ページでは、12のプログラムそれぞれにイラストを用意しています。
イラストはChatGPTで制作しました。ここまでは、いまではそれほど珍しい話ではありません。
今回ちょっと驚いたのは、その先です。
完成したイラストをClaude(Opus 5.5)に渡してアニメーション化をお願いしたところ、「手を何px動かす」「このアイコンを0.5秒後に表示する」といった指示をほとんど書いていないのに、絵の内容を読み取って、Webで使える動きを組み立ててくれました。
静止画を作るAIと、動きを作るAI。
2つをリレーしてみたら、思っていた以上に「Web表現そのものをAIと一緒につくる」感覚に近づいていました。
まずはChatGPTで、12枚の静止画をつくる
最初の工程は、ChatGPTでのイラスト制作です。写真ではなく、サイト上で並べたときに一つのシリーズに見えるイラストを目指しました。
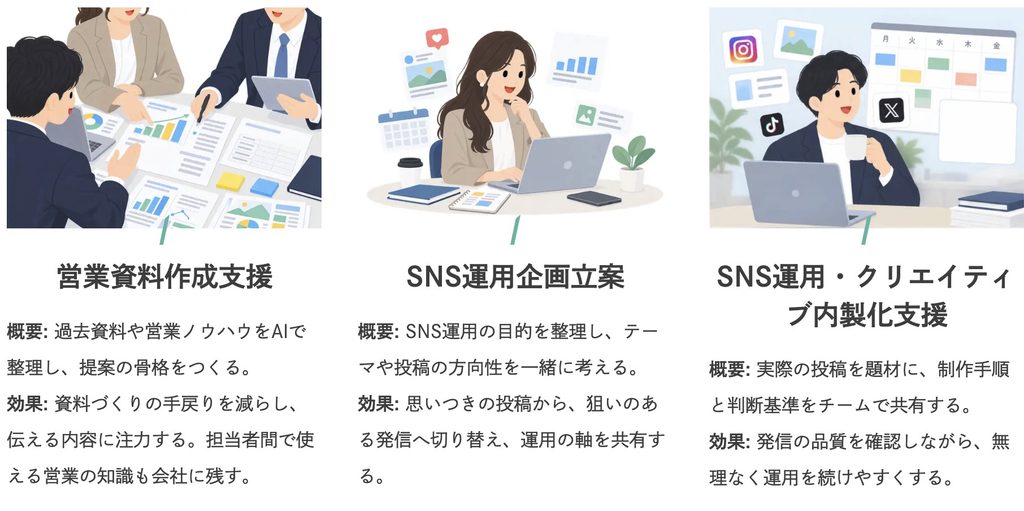
意識したのは、「タッチは固定し、構図だけサービス内容に合わせて変える」ことです。
営業資料作成支援なら人物の顔より手元の資料を大きく見せます。SNS運用企画立案なら、PCに向かう1人のまわりに投稿や分析画面を浮かべます。同じ構図を量産するのではなく、サービスの中身が一目で伝わる構図を1枚ずつ考えました。
もちろん一発で決まったわけではありません。タッチが急にリアルになったり、色が偏ったり、人物が目立ちすぎたりするたびに基準の画像へ戻し、「タッチはこれ」「構図はこちら」と分けて調整しています。
Claudeへの指示は、ほぼこれだけだった
完成した静止画を、Claudeに渡しました。
正直なところ、アニメーションにするなら細かい設計が必要だろうと思っていました。
どのパーツを、どの順番で、何秒かけて動かすのか。本来なら絵コンテやタイムラインを用意する場面です。
ところが、実際に送った指示はこの程度でした。
「12プログラムのイラストに対してイラスト渡すからアニメーションをつけてってほしい」
「次は経営理念・ビジョン浸透プロジェクトだよ」
「これもアニメーション化よろしく」
何を動かすか、どう動かすかは、ほとんど伝えていません。
返ってきたのは、絵の「意味」を読んだ動きだった
驚いたのは、ただ動いたことではありません。そのサービスが何を伝えたいのかに合った動きが選ばれていたことです。
たとえば「AIブレインストーミング・ワークショップ」です。空のホワイトボードに付箋が1枚ずつポンポン貼られていき、最後に電球がチカチカと光ります。アイデアが出て、ひらめく。ワークショップの流れそのものが、4秒ほどのループになっていました。
「経営理念・ビジョン浸透プロジェクト」では、山道に置かれたポイントが麓から順に灯り、山頂に旗が立って風になびきます。目標に向かって一歩ずつ登っていく様子です。
「リモートワークの導入サポート」では、吹き出しの「…」が入力中のようにぴょこぴょこ跳ね、ビデオ会議画面では発言者を示す枠がタイルを順番に移っていきます。
どれも、こちらから「付箋を貼って」「山を登らせて」とは一言も伝えていません。
静止画の中にある意味を読み取り、それを壊さない動きに変換してくれた。これが今回いちばん新しいと感じた点です。
動画生成とは違う。元の絵は描き直していない
もう一つおもしろかったのが、作り方です。
いわゆる動画生成AIのように、映像を新しく生成しているわけではありません。Claudeは元のイラストから付箋・手・グラフ・アイコンといったパーツを切り出し、その裏側の背景を補完したうえで、パーツを1コマずつ動かして組み立てています。仕上がりは、Webでそのまま使えるアニメーションWebPです。
元の絵を描き直していないので、ChatGPTで作ったタッチがそのまま残ります。
12枚並べてもシリーズの統一感が崩れないのは、この作り方のおかげでした。
人が返したのは、デザインレビューのような短い赤字だけ
もちろん、すべてが一発で完成したわけではありません。ただ、こちらからの修正指示は、デザイナーに赤字を入れるときとほとんど変わりませんでした。
「手も少し動いている感じにできる?」
「豆電球のチカチカ、グレーのドロップシャドウみたいなのは汚いから少し変えて欲しい」
「横幅700px以下で作成してくれる?(今後のも全部)」
「手を動かして」と言えば、ペンを持つ手はボードを指してトントンと動き、座っている人の手は会話に合わせてゆらゆら揺れます。2人の動きのリズムも、機械的にそろわないようずらしてくれました。
逆に、AIの側から指摘してくれたこともありました。
- 背景を透過のまま保存するとファイルが重くなるため、サイトの背景に合わせて白背景に切り替えた(1枚あたり1MB前後から、300〜400KB程度に軽量化)
- イラストの中の「AIの回答にも引用される」が「AIの回家にも」になっている誤字を発見
- 透過を示す市松模様が、画像そのものに描き込まれていた2枚を見つけて処理
人が見落としがちな「Webに載せる前の問題」まで拾ってくれたのは、実務的にかなり助かりました。
まとめ|「画像を作るAI」から「Web表現を作るAI」へ
今回の流れを振り返ると、役割分担は次のようになりました。
| 生成AIに任せやすかったこと | 人が判断したこと |
|---|---|
| サービス内容に合わせた構図のイラスト生成(ChatGPT) | タッチ・配色・世界観の基準を決める |
| 絵の意味を読み取り、動かす箇所と順番を決める(Claude) | サービスごとに何を主役にするか |
| パーツの切り出し、背景の補完、アニメーションの書き出し | 動きの強さ・汚れなど見た目の違和感を指摘する |
| ファイルサイズの最適化、誤字や素材の不具合の指摘 | サイズや比率など、サイト側の仕様を決める |
これまでWebにオリジナルのアニメーションを入れるには、イラスト制作、絵コンテ、素材の分解、実装、調整と、デザイナーと映像クリエイターの往復が欠かせませんでした。
今回は、ChatGPTで世界観をつくり、完成したイラストをClaudeに渡し、会話しながら動きを整えて、Webへ掲載するところまで進められました。「先に完璧なアニメーション設計書を作らなくていい。これはWeb制作の進め方そのものが変わりうる」大きな変化だと感じています。
一方で、AIに丸投げしたわけではありません。どんなサービスで、何を主役にし、どんな世界観で見せるのか。その方向を人が決めていたからこそ、AIも迷わず動きを組み立てられたのだと思います。
人が方向を決め、AIが大量の制作工程を担う。
静止画の生成から一歩進んで、Web表現そのものをAIと一緒につくる。そんな制作のかたちを、これからもTWELFTH LABで試していきます。
実際に動いている12のイラストは、AIビジネス活用・内製化支援プログラムのページでご覧いただけます。
この記事は2026年09月公開の記事です。技術の進化等により一部内容が異なることもございます。